Гид · Офлайн-распознавание речи
Офлайн-распознавание речи: приватная диктовка без облака
Всё об офлайн-распознавании речи: как оно работает, чем отличается от облачных сервисов, кому нужно и как начать с VoxSpica на Windows и Linux.
- языка распознавания
- 33языка распознавания
- загрузок в облако
- 0загрузок в облако
- офлайн после установки
- 100%офлайн после установки
- языков интерфейса
- 9языков интерфейса
Что такое офлайн-распознавание речи?
Офлайн-распознавание речи (его ещё называют локальным или «на устройстве») превращает сказанные слова в текст прямо на вашем компьютере. Звук вообще не покидает машину: нет загрузки на сервер, нет обращения к чужому API и нет третьей стороны, которая могла бы хранить или слушать ваши записи.
Облачные сервисы диктовки — Google, Apple, Yandex, Microsoft и большинство онлайн-расшифровок — работают наоборот. Они отправляют микрофон или аудиофайл в дата-центр, запускают там очень большую модель и возвращают текст. Такая модель крупнее и часто точнее, но за это вы платите тем, что ваш голос уходит из компьютера при каждом слове.
В одном предложении: Офлайн-распознавание речи работает полностью на вашем железе, поэтому звук никуда не нужно загружать.
В офлайн-распознавании модель — это и есть программа. Всё нужное уже лежит на диске, поэтому оно работает даже с вынутым сетевым кабелем.
Как это устроено внутри
Большинство офлайн-движков — включая VOSK, который использует VoxSpica, — построены на том же конвейере, что двигает автоматическое распознавание речи (ASR) уже десятилетия: статистическая акустическая модель плюс языковая модель, которые перебирает декодер. Здесь нет магии и не нужен облако.
01
Захват звука
Микрофон или аудиофайл читается потоком сэмплов, обычно 16 кГц, моно, PCM.
02
Извлечение признаков
Короткие окна звука превращаются в компактные спектральные признаки (MFCC), описывающие, как звук меняется во времени.
03
Акустическая модель
Нейросеть сопоставляет эти признаки фонемам — мельчайшим звуковым единицам языка.
04
Языковая модель и декодер
Декодер ищет последовательность слов, которая лучше всего подходит и к звукам, и к правилам языка.
05
Текст
Результат появляется на экране по мере речи или записывается в файл для готовой записи.
Почему офлайн
Облачная диктовка удобна, но держится на допущениях, которые верны не всегда. Офлайн-распознавание убирает их одно за другим.
Приватность по построению
Ваш голос — это биометрические данные. Когда распознавание идёт локально, нет адреса для загрузки, нет расшифровок в чужом аккаунте и нечему утекать. Конфиденциальные интервью, врачебные диктовки и юридические заметки остаются на вашем диске.
Без подписки и квот
Облачная диктовка считает минуты. У локального движка нет часов: десять минут или десять часов — цена одна, ноль.
Работает без интернета
В самолёте, в подвальном офисе, в больничном крыле без Wi-Fi или в стране с урезанным доступом локальная модель продолжает работать.
Меньше задержка
Между вами и распознавателем нет сетевого плеча, поэтому текст появляется почти так же быстро, как вы говорите, и не замирает вместе со связью.
Комплаенс без бумажной работы
Отправка звука третьей стороне — это передача данных, которую GDPR, HIPAA и похожие правила могут требовать раскрывать и защищать. Оставляя звук на машине, вы убираете саму передачу.
Без привязки к поставщику
Движок (VOSK), модели и ваша история — файлы, которые вы контролируете. Если сервис поднимет цену или закроется, ваша настройка не пострадает.
Офлайн и облачная диктовка, пункт за пунктом
Та же таблица, которую вы составили бы для компании: что на самом деле требует каждый подход.
| Признак | Облачная диктовка | VoxSpica (офлайн) |
|---|---|---|
| Интернет | Нужен в каждой сессии | Не нужен после установки |
| Стоимость | Подписка или квота минут | Бесплатно |
| Куда уходит звук | Загружается на чужой сервер | Остаётся на вашем компьютере |
| Аккаунт | Нужен, обычно привязан к личности | Не нужен |
| Хранение данных | Определяет поставщик, часто хранит | Локальный SQLite-файл, который можно удалить |
| Работа без сети | Отказывает без связи | Работает с вынутым кабелем |
| Задержка | Зависит от сети и нагрузки сервера | Локально, без сетевого плеча |
| Потолок точности | Очень высокий (гигантские модели) | От хорошего до очень хорошего, зависит от модели |
Один честный компромисс: на сложном звуке самые крупные облачные модели могут обойти маленькую локальную. Поэтому VoxSpica предлагает и большую модель — баланс скорости, памяти и точности выбираете вы.
Размеры моделей VOSK: small и large
VOSK выпускает две модели на язык, а не три. «Medium» не существует — таблица с small, medium и large это распространённая ошибка, и здесь вы её не найдёте. В каждый установщик VoxSpica уже встроена small-модель; large-модель — разовая загрузка, которую можно добавить позже.
| Модель | Загрузка | ОЗУ в работе | Время загрузки | Лучше всего для |
|---|---|---|---|---|
| Small | ≈40–50 МБ | ≈0,3 ГБ | несколько секунд | Заметки, короткие фразы, старые или малопамятные ПК |
| Large | ≈1–2 ГБ | ≈3–4 ГБ | ≈30–90 секунд | Встречи, интервью, длинные записи, лучшая точность |
Модели Medium не существует
VOSK публикует только small и large. Строка «medium» — вымысел: если страница перечисляет три размера, она угадывает. VoxSpica показывает, какая модель установлена и какие доступны для вашего языка.
У каких языков какие модели
В реестре VOSK из 33 языков VoxSpica у 22 есть и small, и large, у 7 — только small, у 4 — только large. VoxSpica указывает это для каждого языка и никогда не делает вид, что модель существует, если её нет.
Как работает VoxSpica: от звука к тексту
VoxSpica — тонкая и честная обёртка вокруг движка VOSK. Она не выдумывает проценты точности и не скрывает, какая модель работает.
Установите на своём языке
Каждый локализованный установщик уже содержит small-модель для своего языка, поэтому первый запуск работает офлайн без загрузок.
Нажмите запись и говорите
Выберите язык распознавания и размер модели. Модель грузится в фоне, пока окно уже доступно.
Смотрите, как появляется текст
Текст появляется по мере речи, есть пауза и продолжение и стоп, который сохраняет результат. Можно подставить и аудиофайл.
Найдите снова
Каждая сессия — дата, язык, модель, устройство, длительность и текст — пишется в локальную историю SQLite, которую можно искать в программе или из командной строки.
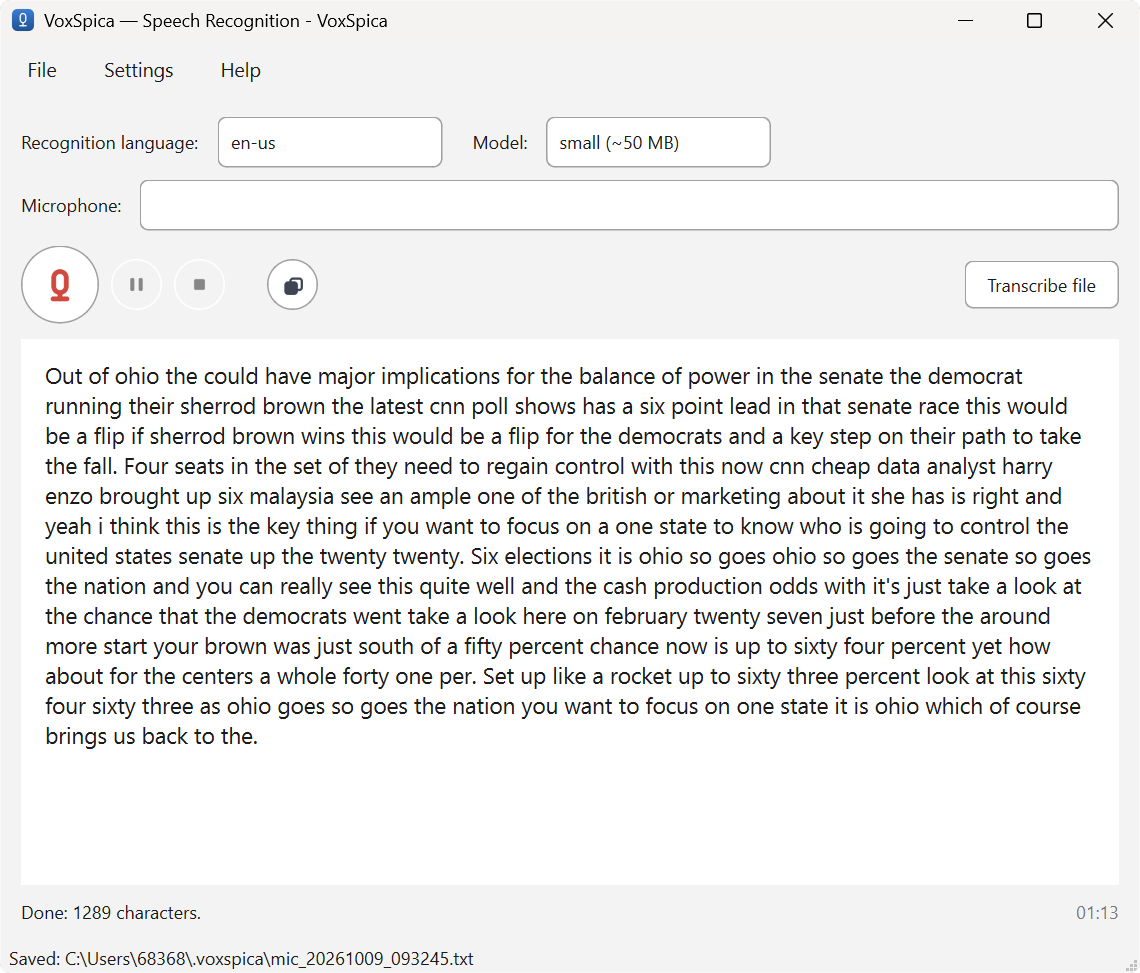
Кому нужна офлайн-диктовка
Если что-то из этого про вас, чисто облачный инструмент — не та форма.
Журналисты и исследователи
Интервью и полевые заметки расшифровываются, не загружая голоса источников куда-либо.
Врачи, юристы, психологи
Конфиденциальная диктовка остаётся на машине практики, без передачи третьим лицам, которую нужно раскрывать.
Студенты
Лекции и семинары пишутся локально, даже в аудитории без рабочего Wi-Fi.
Пользователи с плохой связью
Работает там, где облако зависнет или откажет: село, корабль, самолёт, больница.
Ценители приватности
Ваш голос — только ваш. Ни аккаунта, ни телеметрии, ни отслеживания, ни от чего отказываться.
Офлайн и изолированные контуры
Машины, намеренно отключённые от сети, всё равно превращают речь в текст, если модели на месте.
Установите и начните диктовать
VoxSpica работает на Windows 10/11 и на Ubuntu 22.04/24.04 и Debian 12+ (x64).
Windows
Скачайте установщик для своего языка и запустите. Small-модель уже внутри; первый запуск работает офлайн.
Скачать для WindowsLinux (.deb / APT)
Нативный .deb для Ubuntu и Debian либо APT-репозиторий и установка одной командой: sudo apt update && sudo apt install voxspica
Скачать для LinuxКомандная строка (CLI)
VoxSpica.exe mic, VoxSpica.exe file interview.wav, VoxSpica.exe history --search "meeting" — CLI и окно используют один файл настроек и одну историю.
Читать гидСборки для Windows пока не подписаны кодом, поэтому SmartScreen может предупредить о неизвестном издателе. Выберите «Подробнее → Выполнить в любом случае»; контрольные суммы SHA-256 есть на странице релиза.
Насколько точно офлайн-распознавание?
Точность зависит от трёх вещей: языка, размера модели и звука. Большая модель на чистой речи в хорошо поддержанном языке может быть очень хороша; маленькая на шумной записи с телефона — будет мучиться. Тот, кто даёт одну цифру для «распознавания речи», усредняет по условиям, которые не совпадают с вашими.
VoxSpica честна в этом: она показывает, какая модель установлена, и позволяет переключиться. Если small-модели не хватает для сложной записи, добавьте large для этого языка и прогоните снова.
Что влияет сильнее всего
- Размер модели — большие заметно точнее, но требуют больше ОЗУ и дольше грузятся.
- Качество звука — близкий микрофон лучше далёкого; фоновый шум — самый крупный фактор.
- Поддержка языка — языки с большими данными (английский, русский, немецкий, французский, испанский) идут лучше, чем редкие.
- Манера речи — чёткая связная речь распознаётся лучше, чем сильный гвалт или наложение голосов.
Приватность и безопасность, конкретно
Обещания приватности дешёвы. Вот конкретные факты о том, как VoxSpica обращается с вашими данными.
Нет адреса для загрузки звука
В программе нет адреса, куда можно было бы отправить звук. Распознавание — локальный процесс; записи некуда уходить.
Нет аккаунта и телеметрии
Вы никогда не входите, и приложение не «звонит домой». Нет SDK аналитики и нет слежки за использованием.
Локальная история, которую можно удалить
Расшифровки и история с поиском лежат в вашем профиле (история — файл SQLite). Удалите программу и её папку — не останется ничего.
Вы можете это проверить
Движок открыт (VOSK), и сетевую активность приложения можно наблюдать самому. Выньте сеть — оно продолжит расшифровывать.
Решение проблем
Три вещи, объясняющие большинство вопросов при первом запуске.
- SmartScreen предупреждает о неизвестном издателе — нажмите «Подробнее» → «Выполнить в любом случае». Бинарники для Windows пока не подписаны.
- Звук не распознаётся — проверьте, что выбран правильный язык распознавания и что микрофон не выключен и не заглушён в системных настройках.
- Кажется медленным — попробуйте small-модель, закройте прожорливые приложения или положите модель на SSD. Large-модели нужны несколько ГБ свободной ОЗУ.
33 языка распознавания, все офлайн
VoxSpica распознаёт 33 языка и диалекта локально: от английского, русского, немецкого, французского, испанского и китайского до арабского, хинди, японского, корейского, турецкого и вьетнамского — без участия сети. Сам интерфейс доступен на девяти языках, и распознавание с интерфейсом могут отличаться: диктуйте на одном языке, пока программа говорит на другом.
Частые вопросы
Нужен ли интернет после установки VoxSpica?
Нет. В установщике уже есть small-модель, поэтому программа полностью офлайн с первого запуска. Интернет нужен один раз — скачать установщик (и, по желанию, large-модель).
Есть ли ограничение по длительности диктовки?
Нет. Ни лимита времени, ни квоты. Единственные ограничения — скорость процессора и доступная ОЗУ: large-модели нужно больше памяти и дольше загрузка.
Можно расшифровать аудиофайл, а не микрофон?
Да. VoxSpica обрабатывает WAV напрямую, а mp3/m4a/ogg — при наличии ffmpeg, точно так же, как живую речь.
Нужна ли видеокарта (GPU)?
Нет. Распознавание идёт на процессоре. Small-модель занимает около 0,3 ГБ ОЗУ и стартует за секунды; large нужны несколько ГБ и до минуты и больше на загрузку.
Существует ли «medium»-модель VOSK?
Нет. VOSK публикует только small и large. Если страница показывает medium, такой строки в реальности нет — VoxSpica предлагает только модели, которые действительно есть для вашего языка.
Насколько это точно по сравнению с облаком?
На сложном звуке крупнейшие облачные модели могут немного обойти маленькую локальную, потому что они куда больше. На чистой речи большая модель VOSK близка к ним, а в отличие от облака бесплатна и ничего не отправляет. VoxSpica говорит, какая модель используется.
Работает ли в виртуалке, контейнере или изолированной машине?
Да. Поскольку распознавание локальное, машина, которая вообще не выходит в сеть, всё равно расшифрует речь — если на месте файлы моделей.
Что происходит с моими записями и расшифровками?
Ничего не пишется, пока вы не попросите. Расшифровки сохраняются туда, куда вы укажете, а история с поиском — это локальный SQLite-файл в вашем профиле. Удалите папку программы — и данных нет.
Можно использовать из командной строки?
Да. VoxSpica.exe mic, VoxSpica.exe file meeting.mp3 и VoxSpica.exe history --search "meeting" работают без окна; у CLI и окна общие настройки, история и модели.
Какие системы поддерживаются?
Windows 10 и 11 (64-бит) и Linux: Ubuntu 22.04/24.04 и Debian 12+, x64. 32-битной сборки и сборки под macOS пока нет.
Диктуйте, не отдавая голос
Бесплатно, офлайн и приватно на Windows и Linux. Выберите язык, установите, нажмите запись.