指南 · 离线语音识别
离线语音转文字:无需云端的私密听写
关于离线语音识别的一切:它如何工作、与云端服务有何不同、谁需要它,以及如何在 Windows 和 Linux 上用 VoxSpica 开始。
- 种识别语言
- 33种识别语言
- 云端上传
- 0云端上传
- 安装后离线
- 100%安装后离线
- 种界面语言
- 9种界面语言
什么是离线语音转文字?
离线语音转文字(也叫设备端或本地语音识别)直接在你的电脑上把说的话变成文字。音频从不离开这台机器:没有上传,没有与服务器的往返,也没有第三方能够存储或监听。
云端听写服务——Google、Apple、Yandex、Microsoft 以及大多数网页转录工具——正好相反。它们把你的麦克风或音频文件传送到数据中心,在那里运行一个非常大的模型,再把文字发回来。那个模型更大、往往更准确,但也意味着你每次说话,声音都会离开你的电脑。
一句话: 离线语音转文字是完全在你自己的硬件上运行的语音识别,因此音频无需上传到任何地方。
在离线识别中,模型就是程序本身。它所需的一切已经在你的磁盘上,所以拔掉网线它照样工作。
它在底层如何工作
大多数离线引擎——包括 VoxSpica 使用的 VOSK——都建立在几十年来驱动自动语音识别(ASR)的同一条流水线上:一个统计声学模型加一个语言模型,由解码器进行搜索。这里没有魔法,也不需要云端。
01
音频采集
麦克风或音频文件以采样流的形式读入,通常是 16 kHz 单声道 PCM。
02
特征提取
短时声音窗口被转换成紧凑的频谱特征(MFCC),描述声音随时间的变化。
03
声学模型
神经网络把这些特征映射到音素——构成一种语言的最小声音单位。
04
语言模型与解码器
解码器搜索与声音和语言规则最吻合的词序列。
05
文本输出
结果会随着你说话显示在屏幕上,或写入你提供的录音文件。
为什么要离线
云端听写很方便,但它建立在并非总是成立的假设之上。离线识别把它们逐一去掉。
隐私始于设计
你的声音属于生物特征数据。识别在本地运行时,没有上传端点、没有躺在厂商账户里的转录、也没有可泄露的数据。机密采访、医疗听写和法律笔记都留在你的磁盘上。
无订阅、无配额
云端听写按分钟计费。本地引擎没有时钟:听写十分钟还是十小时,成本都一样——零。
无需互联网也能工作
在飞机上、没有 Wi-Fi 的地下办公室、医院走廊,或在限制访问的地区,本地模型照常工作。
更低延迟,无需往返
你与识别器之间没有网络跳转,因此文字几乎能和你说话一样快地出现,也不会因连接卡顿而停顿。
合规无需文书
把音频发送给第三方是一种数据传输,GDPR、HIPAA 及类似规则可能要求你披露并保护它。把音频留在本机,就彻底消除了这种传输。
无厂商锁定
引擎(VOSK)、模型和你的历史都是你能控制的文件。即使某个服务改价或关停,你的配置也不受影响。
离线与云端听写,逐项对比
如果你为公司做选型,你会做的正是这张表:每种方案究竟需要什么。
| 特性 | 云端听写 | VoxSpica(离线) |
|---|---|---|
| 互联网连接 | 每次会话都需要 | 安装后无需 |
| 费用 | 订阅或按分钟配额 | 免费 |
| 音频去向 | 上传到第三方服务器 | 留在你的电脑上 |
| 账户 | 必需,通常绑定身份 | 无需 |
| 数据留存 | 由厂商决定,常常保存 | 本地 SQLite 文件,可自行删除 |
| 离线可用性 | 无连接即失效 | 拔掉网线仍可用 |
| 延迟 | 取决于网络和服务器负载 | 本地运行,无需往返 |
| 准确率上限 | 非常高(超大规模模型) | 良好到很好,取决于模型 |
一个诚实的取舍:在困难音频上,最大的云端模型能胜过小型本地模型。正因如此,VoxSpica 也提供大型模型——由你选择速度、内存与准确率之间的平衡。
VOSK 模型尺寸:小型和大型
VOSK 每种语言只提供两种模型尺寸,而不是三种。没有“中型”——列出小、中、大三档的表格是常见错误,这里不会有。每个 VoxSpica 安装程序都内置一个小型模型;大型模型是一次性下载,可稍后添加。
| 模型 | 下载 | 运行内存 | 加载时间 | 最适合 |
|---|---|---|---|---|
| 小型 | ≈40–50 MB | ≈0.3 GB | 几秒 | 笔记、短语、较旧或内存较小的电脑 |
| 大型 | ≈1–2 GB | ≈3–4 GB | ≈30–90 秒 | 会议、采访、长录音、最佳准确率 |
没有中型模型
VOSK 只发布小型和大型模型。“中型”那一行是虚构的——如果一个页面列出三种尺寸,它就是在猜。VoxSpica 会准确显示已安装的模型,以及你的语言有哪些可用模型。
哪些语言有哪些模型
在 VOSK 注册表中,VoxSpica 的 33 种语言里有 22 种同时提供小型和大型模型,7 种只有小型,4 种只有大型。VoxSpica 会按语言如实标注,绝不假装某个不存在的模型存在。
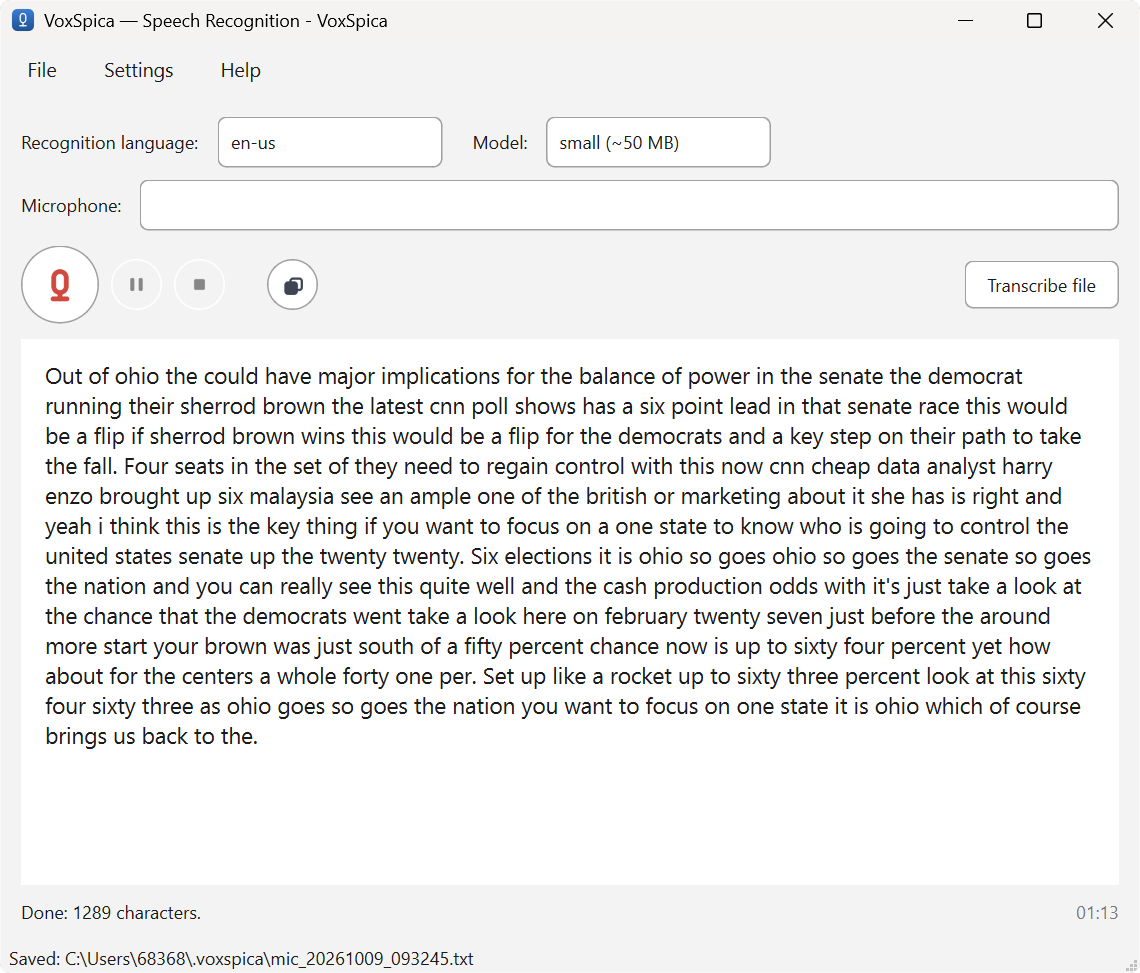
VoxSpica 如何工作:从声音到文字
VoxSpica 是 VOSK 引擎之上的一层轻薄而诚实的封装。它不会编造准确率数字,也不隐瞒正在运行哪个模型。
按你的语言安装
每个本地化安装程序都已包含该语言的小型识别模型,因此首次启动即可离线工作,无需下载。
按下录音并说话
选择识别语言和模型大小。模型在后台加载,同时窗口已经可以使用。
看着文字出现
文字随着你说话出现,支持暂停与继续,以及保留结果的停止。你也可以交给它一个音频文件。
再次找到它
每次会话——日期、语言、模型、设备、时长和文字——都会写入本地 SQLite 历史,可在应用内或命令行中搜索。
谁需要离线听写
如果以下任何一种符合你的处境,纯云端工具就是错误的选择。
记者和研究人员
转录采访和田野笔记,无需把消息来源的声音上传到任何地方。
医生、律师、治疗师
机密听写留在诊所自己的机器上,没有需要披露的第三方数据传输。
学生
讲座和研讨会在本地录制,即使在没有可用 Wi-Fi 的大教室里也一样。
低带宽用户
在云端服务会卡住或失败的地方也能用:乡村、船上、飞机上、医院。
隐私拥护者
你的声音只属于你。没有账户、没有遥测、没有追踪,无需选择退出。
离线与隔离环境
被有意断网的机器,只要模型文件在,依然能把语音转成文字。
安装并开始听写
VoxSpica 支持 Windows 10/11,以及 Ubuntu 22.04/24.04 和 Debian 12+(x64)。
Linux(.deb / APT)
适用于 Ubuntu 和 Debian 的原生 .deb,或添加 APT 仓库并用一条命令安装:sudo apt update && sudo apt install voxspica
下载 Linux 版命令行(CLI)
VoxSpica.exe mic、VoxSpica.exe file interview.wav、VoxSpica.exe history --search "meeting"——CLI 与窗口共用同一个设置文件和同一份历史。
阅读指南Windows 版本尚未代码签名,因此 SmartScreen 可能提示未知发布者。请选择“更多信息 → 仍要运行”;发布页上有 SHA-256 校验和。
离线识别有多准确?
准确率取决于三件事:语言、模型大小和音频。大型模型在支持良好的语言上处理清晰语音可以非常出色;小型模型面对嘈杂的电话录音则力不从心。任何给你一个“语音识别”单一百分比的人,都是在你不适用的条件下取平均。
VoxSpica 对此很诚实:它会显示已安装的模型,并允许你切换。如果小型模型应付不了某段困难的录音,为该语言添加大型模型后重跑即可。
影响准确率的因素
- 模型大小——大型模型明显更准确,但需要更多内存和更长加载时间。
- 音频质量——近距麦克风胜过远距;背景噪音是最大的单一因素。
- 语言支持——训练数据更多的语言(英语、俄语、德语、法语、西班牙语)表现优于低资源语言。
- 说话方式——清晰连贯的语音比严重串话或多人重叠更容易转写。
隐私与安全,具体来说
隐私承诺很廉价。以下是 VoxSpica 如何处理你数据的具体事实。
没有音频上传端点
程序里没有任何可以把音频发出去的地址。识别是本地进程;录音无处可去。
无账户、无遥测
你从不需要登录,应用也不会回传数据。没有分析 SDK,也没有使用追踪。
本地、可删除的历史
转录和可搜索历史保存在你的用户配置文件中(历史为 SQLite 文件)。删除应用及其文件夹,什么都不会留下。
你可以自行验证
引擎是开源的(VOSK),你也可以亲自观察应用的网络活动。拔掉网络,它照样转写。
故障排除
首次运行最常见的三个问题。
- SmartScreen 警告未知发布者——点击“更多信息”→“仍要运行”。Windows 二进制文件尚未代码签名。
- 无法识别声音——检查是否选择了正确的识别语言,以及麦克风在系统设置中未被静音或禁用。
- 感觉很慢——尝试小型模型,关闭占用内存的应用,或把模型放到 SSD 上。大型模型需要数 GB 空闲内存。
33 种识别语言,全部离线
VoxSpica 在本地识别 33 种语言和方言,从英语、俄语、德语、法语、西班牙语和中文,到阿拉伯语、印地语、日语、韩语、土耳其语和越南语——全程不联网。界面本身支持九种语言,识别语言与界面语言可以不同:用一种语言听写,同时让应用说另一种语言。
常见问题
安装 VoxSpica 后还需要互联网吗?
不需要。安装程序已内置小型模型,因此首次启动即可完全离线工作。互联网只在下载安装程序时用一次(以及可选地下载大型模型)。
听写时长有限制吗?
没有。没有时间限制,也没有配额。唯一的限制是你的 CPU 速度和可用内存——大型模型需要更多内存和更长加载时间。
可以转录音频文件而不是麦克风吗?
可以。VoxSpica 直接处理 WAV,并在有 ffmpeg 时处理 mp3/m4a/ogg,与处理实时语音完全相同。
需要显卡(GPU)吗?
不需要。识别在 CPU 上运行。小型模型约占 0.3 GB 内存,几秒内启动;大型模型需要数 GB,加载可能长达一分钟或更久。
有“中型”VOSK 模型吗?
没有。VOSK 只发布小型和大型模型。如果某个页面显示中型,那一行在现实中并不存在——VoxSpica 只提供你的语言真实存在的模型。
与云端服务相比准确率如何?
在困难音频上,最大的云端模型能略胜小型本地模型,因为它们大得多。对于清晰语音,大型 VOSK 模型已很接近;而且与云端不同,它免费、不外发任何数据。VoxSpica 会告诉你正在使用哪个模型。
能在虚拟机、容器或隔离机器上运行吗?
可以。由于识别是本地进行的,只要模型文件在,从不联网的机器也能转写语音。
我的录音和转录会怎样?
除非你要求,否则什么都不会写入。转录保存在你选择的位置,可搜索历史是你用户配置文件里的本地 SQLite 文件。删除应用文件夹,数据即消失。
可以从命令行使用吗?
可以。VoxSpica.exe mic、VoxSpica.exe file meeting.mp3 和 VoxSpica.exe history --search "meeting" 均可无界面运行;CLI 与窗口共用同一个设置文件、同一份历史和同一套模型。
支持哪些系统?
Windows 10 和 11(64 位),以及 Linux:Ubuntu 22.04/24.04 和 Debian 12+,x64。暂无 32 位版本和 macOS 版本。