Ratgeber · Offline-Spracherkennung
Offline-Spracherkennung: privates Diktat ohne Cloud
Alles über Offline-Spracherkennung: wie sie funktioniert, wie sie sich von Cloud-Diensten unterscheidet, für wen sie gedacht ist und wie Sie mit VoxSpica unter Windows und Linux starten.
- Erkennungssprachen
- 33Erkennungssprachen
- Uploads in die Cloud
- 0Uploads in die Cloud
- offline nach Installation
- 100 %offline nach Installation
- Oberflächensprachen
- 9Oberflächensprachen
Was ist Offline-Spracherkennung?
Offline-Spracherkennung (auch On-Device- oder lokale Spracherkennung genannt) wandelt gesprochene Worte direkt auf Ihrem Computer in Text um. Das Audio verlässt das Gerät nie: kein Upload, kein Umweg über einen Server, kein Dritter, der mithören oder speichern kann.
Cloud-Diktatdienste — Google, Apple, Yandex, Microsoft und die meisten webbasierten Transkriptionstools — funktionieren umgekehrt. Sie streamen Ihr Mikrofon oder Ihre Audiodatei in ein Rechenzentrum, betreiben dort ein sehr großes Modell und schicken den Text zurück. Dieses Modell ist größer und oft genauer, aber Ihre Stimme verlässt bei jedem Satz den Computer.
In einem Satz: Offline-Spracherkennung läuft vollständig auf Ihrer eigenen Hardware, sodass Audio nirgendwohin hochgeladen werden muss.
Bei Offline-Erkennung ist das Modell das Programm. Alles, was es braucht, liegt bereits auf Ihrer Festplatte — es funktioniert auch mit gezogenem Netzwerkkabel.
Wie es technisch funktioniert
Die meisten Offline-Engines — auch VOSK, das VoxSpica verwendet — beruhen auf derselben Pipeline, die die automatische Spracherkennung (ASR) seit Jahrzehnten antreibt: ein statistisches akustisches Modell plus ein Sprachmodell, durchsucht von einem Decoder. Nichts davon ist Magie, und nichts davon braucht die Cloud.
01
Audioaufnahme
Mikrofon oder Audiodatei werden als Strom von Samples gelesen, üblicherweise 16 kHz Mono-PCM.
02
Merkmalsextraktion
Kurze Schallfenster werden in kompakte Spektralmerkmale (MFCCs) umgewandelt, die beschreiben, wie sich der Klang über die Zeit verändert.
03
Akustisches Modell
Ein neuronales Netz ordnet diese Merkmale Phonemen zu — den kleinen Klangeinheiten, aus denen eine Sprache besteht.
04
Sprachmodell und Decoder
Der Decoder sucht die Wortfolge, die am besten zu Klang und Sprachregeln passt.
05
Textausgabe
Das Ergebnis erscheint während des Sprechens auf dem Bildschirm oder wird für eine gelieferte Aufnahme in eine Datei geschrieben.
Warum offline
Cloud-Diktat ist bequem, beruht aber auf Annahmen, die nicht immer zutreffen. Offline-Erkennung nimmt sie eine nach der anderen weg.
Datenschutz von Grund auf
Ihre Stimme ist biometrischer Natur. Läuft die Erkennung lokal, gibt es keinen Upload-Endpunkt, kein Transkript im Konto eines Anbieters und nichts, was lecken kann. Vertrauliche Interviews, medizinische Diktate und juristische Notizen bleiben auf Ihrer Festplatte.
Kein Abo, kein Kontingent
Cloud-Diktat rechnet nach Minuten ab. Eine lokale Engine hat keine Uhr: zehn Minuten oder zehn Stunden kosten dasselbe — nichts.
Funktioniert ohne Internet
Im Flugzeug, im Kellerbüro, im Krankenhausflügel ohne WLAN oder in einem Land mit gedrosseltem Zugang läuft ein lokales Modell weiter.
Geringere Latenz
Es gibt keinen Netzwerksprung zwischen Ihnen und dem Erkennungssystem; Text erscheint fast so schnell, wie Sie sprechen, und stockt nicht, wenn die Verbindung stockt.
Compliance ohne Papierkram
Audio an Dritte zu senden, ist eine Datenübermittlung, die DSGVO, HIPAA und ähnliche Regeln offenlegen und absichern können. Bleibt das Audio auf dem Rechner, entfällt die Übermittlung.
Keine Anbieterbindung
Engine (VOSK), Modelle und Ihr Verlauf sind Dateien, die Sie kontrollieren. Ändert ein Dienst seine Preise oder schließt, betrifft das Ihre Einrichtung nicht.
Offline vs. Cloud-Diktat, Punkt für Punkt
Dieselbe Tabelle, die Sie für ein Unternehmen aufstellen würden: Was jede Variante tatsächlich erfordert.
| Merkmal | Cloud-Diktat | VoxSpica (offline) |
|---|---|---|
| Internetverbindung | Für jede Sitzung nötig | Nach der Installation nicht nötig |
| Kosten | Abo oder Minutenkontingent | Kostenlos |
| Wohin das Audio geht | Upload auf einen Drittserver | Bleibt auf Ihrem Computer |
| Konto | Nötig, meist an eine Identität gebunden | Keins |
| Datenspeicherung | Vom Anbieter bestimmt, oft gespeichert | Lokale SQLite-Datei, die Sie löschen können |
| Offline-Verfügbarkeit | Scheitert ohne Verbindung | Läuft mit gezogenem Kabel |
| Latenz | Abhängig von Netz und Serverlast | Lokal, kein Umweg |
| Genauigkeitsgrenze | Sehr hoch (riesige Modelle) | Gut bis sehr gut, modellabhängig |
Der eine ehrliche Kompromiss: Die größten Cloud-Modelle können bei schwierigem Audio ein kleines lokales Modell schlagen. Deshalb bietet VoxSpica auch ein großes Modell — Sie wählen das Verhältnis von Tempo, Speicher und Genauigkeit.
VOSK-Modellgrößen: klein und groß
VOSK liefert zwei Modellgrößen pro Sprache, nicht drei. Ein 'medium' gibt es nicht — eine Tabelle mit klein, mittel und groß ist ein häufiger Fehler, und hier finden Sie ihn nicht. Jeder VoxSpica-Installer enthält ein kleines Modell; das große Modell ist ein einmaliger Download, den Sie später hinzufügen.
| Modell | Download | RAM im Betrieb | Ladezeit | Am besten für |
|---|---|---|---|---|
| Klein | ≈40–50 MB | ≈0,3 GB | wenige Sekunden | Notizen, kurze Sätze, ältere oder RAM-arme Computer |
| Groß | ≈1–2 GB | ≈3–4 GB | ≈30–90 Sekunden | Besprechungen, Interviews, lange Aufnahmen, beste Genauigkeit |
Es gibt kein Medium-Modell
VOSK veröffentlicht nur kleine und große Modelle. Eine „Mittel“-Zeile ist Fiktion — wenn eine Seite drei Größen nennt, rät sie. VoxSpica zeigt genau, welches Modell installiert ist und welche für Ihre Sprache verfügbar sind.
Welche Sprache welches Modell hat
In der VOSK-Registry gibt es für 22 der 33 Sprachen von VoxSpica sowohl ein kleines als auch ein großes Modell, 7 haben nur ein kleines und 4 nur ein großes. VoxSpica weist das pro Sprache aus und tut nie so, als gäbe es ein Modell, das es nicht gibt.
So arbeitet VoxSpica: von Klang zu Text
VoxSpica ist ein schlanker, ehrlicher Aufsatz auf die VOSK-Engine. Es erfindet keine Genauigkeitszahlen und versteckt nicht, welches Modell läuft.
In Ihrer Sprache installieren
Jeder lokalisierte Installer enthält bereits ein kleines Erkennungsmodell für diese Sprache; der erste Start läuft offline ohne Download.
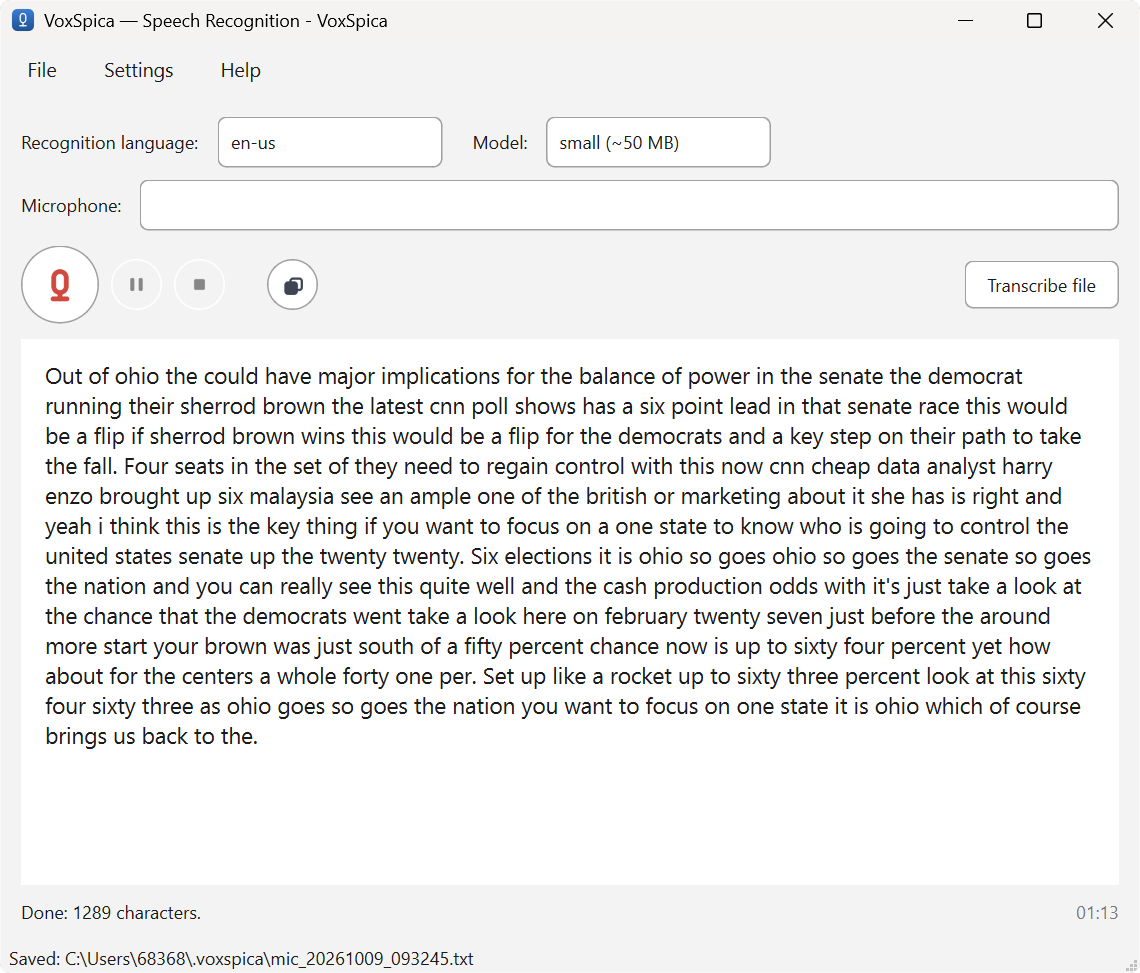
Aufnahme drücken und sprechen
Wählen Sie Erkennungssprache und Modellgröße. Das Modell lädt im Hintergrund, während das Fenster schon nutzbar ist.
Text erscheinen sehen
Text erscheint während des Sprechens, mit Pause und Fortsetzen und einem Stopp, der das Ergebnis behält. Sie können auch eine Audiodatei übergeben.
Wiederfinden
Jede Sitzung — Datum, Sprache, Modell, Gerät, Dauer und Text — landet in einem lokalen SQLite-Verlauf, den Sie in der App oder per Kommandozeile durchsuchen.
Für wen Offline-Diktat gedacht ist
Wenn eines davon auf Sie zutrifft, ist ein reines Cloud-Tool die falsche Form.
Journalisten und Forscher
Interviews und Feldnotizen werden transkribiert, ohne die Stimmen der Quellen irgendwohin hochzuladen.
Ärzte, Anwälte, Therapeuten
Vertrauliches Diktat bleibt auf dem Rechner der Praxis, ohne Drittübermittlung, die offengelegt werden müsste.
Studenten
Vorlesungen und Seminare werden lokal erfasst, auch in einem Hörsaal ohne brauchbares WLAN.
Nutzer mit wenig Bandbreite
Funktioniert dort, wo ein Cloud-Dienst hängt oder scheitert: ländliche Gebiete, Schiffe, Flugzeuge, Krankenhäuser.
Datenschutzbewusste
Ihre Stimme gehört Ihnen. Kein Konto, keine Telemetrie, kein Tracking, nichts zum Abwählen.
Offline- und Air-Gap-Setups
Rechner, die bewusst vom Netz getrennt sind, können Sprache trotzdem in Text umwandeln.
Installieren und lostippen
VoxSpica läuft auf Windows 10/11 sowie Ubuntu 22.04/24.04 und Debian 12+ (x64).
Windows
Laden Sie den Installer für Ihre Sprache herunter und führen Sie ihn aus. Das kleine Modell ist bereits enthalten; der erste Start funktioniert offline.
Für Windows herunterladenLinux (.deb / APT)
Ein natives .deb für Ubuntu und Debian, oder APT-Repository einbinden und mit einem Befehl installieren: sudo apt update && sudo apt install voxspica
Für Linux herunterladenKommandozeile (CLI)
VoxSpica.exe mic, VoxSpica.exe file interview.wav, VoxSpica.exe history --search "meeting" — CLI und Fenster teilen eine Einstellungsdatei und einen Verlauf.
Anleitung lesenWindows-Builds sind noch nicht codesigniert, daher kann SmartScreen vor einem unbekannten Herausgeber warnen. Wählen Sie „Weitere Informationen → Trotzdem ausführen“; SHA-256-Prüfsummen stehen auf der Release-Seite.
Wie genau ist Offline-Erkennung?
Die Genauigkeit hängt von drei Dingen ab: Sprache, Modellgröße und Audio. Ein großes Modell mit klarer Sprache in einer gut unterstützten Sprache kann sehr gut sein; ein kleines Modell mit verrauschtem Telefon-Audio tut sich schwer. Wer Ihnen eine einzelne Prozentzahl für „Spracherkennung“ nennt, mittelt über Bedingungen, die nicht Ihre sind.
VoxSpica ist hier ehrlich: Es zeigt, welches Modell installiert ist, und lässt Sie wechseln. Reicht das kleine Modell für eine schwierige Aufnahme nicht, fügen Sie das große Modell für diese Sprache hinzu und starten Sie erneut.
Was den Unterschied macht
- Modellgröße — große Modelle sind deutlich genauer, brauchen aber mehr RAM und länger zum Laden.
- Audioqualität — ein nahes Mikrofon schlägt ein fernes; Hintergrundgeräusche sind der größte Einzelfaktor.
- Sprachunterstützung — Sprachen mit mehr Trainingsdaten (Englisch, Russisch, Deutsch, Französisch, Spanisch) schneiden besser ab als ressourcenarme.
- Sprechweise — klare, zusammenhängende Sprache transkribiert besser als starkes Durcheinander oder überlappende Sprecher.
Datenschutz und Sicherheit, konkret
Datenschutzversprechen sind billig. Das sind die konkreten Fakten, wie VoxSpica mit Ihren Daten umgeht.
Kein Upload-Endpunkt
Das Programm enthält keine Adresse, an die Ihr Audio gesendet werden könnte. Erkennung ist ein lokaler Prozess; es gibt keinen Ort, an den eine Aufnahme gehen könnte.
Kein Konto, keine Telemetrie
Sie melden sich nie an, und die App ruft nicht nach Hause. Es gibt kein Analyse-SDK und kein Nutzungstracking.
Lokaler, löschbarer Verlauf
Transkripte und der durchsuchbare Verlauf liegen in Ihrem Benutzerprofil (Verlauf in einer SQLite-Datei). Löschen Sie App und Ordner, bleibt nichts zurück.
Sie können es überprüfen
Die Engine ist Open Source (VOSK), und Sie können den Netzwerkverkehr der App selbst beobachten. Ziehen Sie das Netzwerk ab — sie transkribiert weiter.
Fehlerbehebung
Die drei Punkte, die die meisten Fragen beim ersten Start erklären.
- SmartScreen warnt vor einem unbekannten Herausgeber — klicken Sie auf „Weitere Informationen“ → „Trotzdem ausführen“. Windows-Binärdateien sind noch nicht codesigniert.
- Ton wird nicht erkannt — prüfen Sie, ob die richtige Erkennungssprache gewählt ist und ob das Mikrofon in den Systemeinstellungen nicht stummgeschaltet oder deaktiviert ist.
- Es wirkt langsam — versuchen Sie das kleine Modell, schließen Sie speicherhungrige Apps oder legen Sie das Modell auf eine SSD. Große Modelle brauchen mehrere GB freien RAM.
33 Erkennungssprachen, alle offline
VoxSpica erkennt 33 Sprachen und Dialekte lokal, von Englisch, Russisch, Deutsch, Französisch, Spanisch und Chinesisch bis Arabisch, Hindi, Japanisch, Koreanisch, Türkisch und Vietnamesisch — ohne Netzwerk. Die Oberfläche selbst gibt es in neun Sprachen, und Erkennung und Oberfläche dürfen sich unterscheiden: Diktieren Sie in einer Sprache, während die App in einer anderen spricht.
Häufig gestellte Fragen
Brauche ich nach der Installation von VoxSpica das Internet?
Nein. Der Installer enthält bereits ein kleines Modell, sodass das Programm ab dem ersten Start vollständig offline arbeitet. Das Internet wird einmal genutzt, um den Installer (und optional ein großes Modell) herunterzuladen.
Gibt es ein Zeitlimit für das Diktat?
Nein. Es gibt kein Zeitlimit und kein Kontingent. Die einzigen Grenzen sind Ihre CPU-Geschwindigkeit und der verfügbare RAM — ein großes Modell braucht mehr Speicher und lädt länger.
Kann ich eine Audiodatei statt des Mikrofons transkribieren?
Ja. VoxSpica verarbeitet WAV direkt und mp3/m4a/ogg, wenn ffmpeg verfügbar ist — genauso wie Live-Sprache.
Brauche ich eine Grafikkarte (GPU)?
Nein. Die Erkennung läuft auf der CPU. Ein kleines Modell nutzt etwa 0,3 GB RAM und startet in Sekunden; ein großes braucht einige GB und bis zu einer Minute oder mehr zum Laden.
Gibt es ein „Medium“-VOSK-Modell?
Nein. VOSK veröffentlicht nur kleine und große Modelle. Wenn eine Seite eine mittlere Größe zeigt, existiert diese Zeile in Wirklichkeit nicht — VoxSpica bietet nur Modelle, die es für Ihre Sprache tatsächlich gibt.
Wie genau ist es im Vergleich zu Cloud-Diensten?
Bei schwierigem Audio können die allergrößten Cloud-Modelle ein kleines lokales Modell knapp schlagen, weil sie viel größer sind. Bei klarer Sprache ist ein großes VOSK-Modell nahe dran und kostet — anders als die Cloud — nichts und sendet nichts. VoxSpica sagt Ihnen, welches Modell Sie verwenden.
Läuft es in einer VM, einem Container oder einer Air-Gap-Maschine?
Ja. Da die Erkennung lokal ist, kann ein Rechner, der nie das Netzwerk berührt, Sprache trotzdem transkribieren, solange die Modelldateien vorhanden sind.
Was passiert mit meinen Aufnahmen und Transkripten?
Nichts wird geschrieben, außer Sie verlangen es. Transkripte werden dort gespeichert, wo Sie es wählen, und der durchsuchbare Verlauf ist eine lokale SQLite-Datei in Ihrem Benutzerprofil. Löschen Sie den App-Ordner, sind die Daten weg.
Kann ich es von der Kommandozeile aus verwenden?
Ja. VoxSpica.exe mic, VoxSpica.exe file meeting.mp3 und VoxSpica.exe history --search "meeting" laufen ohne Fenster; CLI und Fenster teilen eine Einstellungsdatei, einen Verlauf und einen Satz Modelle.
Welche Systeme werden unterstützt?
Windows 10 und 11 (64-Bit) sowie Linux: Ubuntu 22.04/24.04 und Debian 12+, x64. Es gibt noch keinen 32-Bit-Build und keinen macOS-Build.
Diktieren, ohne Ihre Stimme wegzugeben
Kostenlos, offline und privat unter Windows und Linux. Sprache wählen, installieren, Aufnahme drücken.